بسیاری از شرکتها پس از راهاندازی سامانههای هوش مصنوعی صوتی با افت شدید عملکرد مواجه میشوند و علت این افت را درک نمیکنند. تبدیل صوت به متن شاید روی دموی آزمایشگاهی شبیه به یک جادو به نظر برسد، اما در دنیای واقعی داستان کاملاً فرق دارد. فناوری پردازش گفتار فارسی در گلوگاه ارتباطات تلفنی با صدها مانع آکوستیک و زبانی دستوپنجه نرم میکند. زبان فارسی به دلیل تنوع لهجه، شکاف میان نوشتار و گفتار و خطوط نامطلوب مخابراتی، به معماری بسیار پیشرفتهتری نسبت به زبان انگلیسی نیاز دارد. در این مقاله به بررسی دقیق چرایی شکست پروژههای سنتی تشخیص گفتار و راهکارهای غلبه بر این موانع میپردازیم.
موانع پنهان پردازش گفتار فارسی در خطوط مخابراتی
اولین ضربه مهلک به کیفیت دادههای صوتی، قبل از رسیدن صدا به سرورهای هوش مصنوعی وارد میشود. فناوری تلفن سنتی صدا را به شدت فشرده میکند و فرکانسهای بالا و پایین انسان را به کلی میبرد. پیادهسازی پردازش گفتار فارسی روی صدای با نرخ نمونهبرداری ۸ کیلوهرتز نیازمند فیلترهای حذف نویز فوقالعاده حساس است. وقتی داده ورودی ناقص باشد، حتی قویترین مدلهای هوش مصنوعی نیز دچار خطای توهم یا کلمات نامفهوم میشوند. بنابراین، سازمانها باید قبل از هر اقدامی، کیفیت فشردهسازی بستههای صوتی را در زیرساخت شبکه خود اصلاح کنند.
پهنای باند محدود و اثر مخرب آن بر پردازش گفتار فارسی
در شبکههای تلفنی رایج، پهنای باند باریک باعث حذف جزئیات دقیق صامتها مانند «س»، «ش» یا «ف» میشود. این پدیده، فرایند پردازش گفتار فارسی را با چالشهای شناختی جدی روبهرو میسازد؛ زیرا تفکیک کلمات همآوا سخت میشود. علاوه بر این، نویز پسزمینه در محیط زندگی مشتری مانند صدای بوق ماشین، تلویزیون یا همهمه خیابان، الگوهای صوتی را مخدوش میکند. برای عبور از این بحران، مهندسان سیستم باید از الگوریتمهای پیشپردازش صوتی و لغو پژواک برای تفکیک صدای اصلی بهره بگیرند.
لهجهها و اصطلاحات عامیانه؛ گلوگاههای پردازش گفتار فارسی
مردم هنگام تماس با مراکز پشتیبانی، با زبان رسمی کتابهای درسی صحبت نمیکنند، بلکه احساسات و خشم خود را به زبان کوچه و بازار میگویند. دومین چالش بزرگ در زمینه پردازش گفتار فارسی، تنوع لهجههای بومی و تفاوت فاحش ساختار فعل در گفتار عامیانه است. تغییر حروف، کشیدگی مصوتها و ابداع اصطلاحات روزمره نیازمند مدلهای آکوستیک اختصاصی هستند که روی دادههای بومی آموزش دیده باشند. متاسفانه اغلب مدلهای عمومی بینالمللی هیچ شناختی از این ظرافتهای معنایی فرهنگ ایرانی ندارند و مکالمات غیررسمی را غلط پیادهسازی میکنند.
مدیریت زبان محاورهای در مدلهای زبانی صوتمحور
برای دستیابی به درک معنایی بالا، موتور تبدیل صوت باید به یک مدل زبانی اختصاصی متصل باشد. این ادغام هوشمند باعث میشود سامانه بتواند خطاهای آوایی را براساس زمینه کلی جمله اصلاح کند. هنگامی که یک مشتری از اصطلاحی عامیانه استفاده میکند، موتور پردازشگر باید منظور پنهان پشت کلمات را تشخیص دهد. بدون این انعطافپذیری زبانی، سیستمهای پاسخگوی هوشمند نمیتوانند نیاز واقعی کاربران را بفهمند و در نهایت تماس به اپراتور انسانی ارجاع میشود.
تفاوت حیاتی محیط آزمایشگاهی با دنیای واقعی در پردازش گفتار فارسی
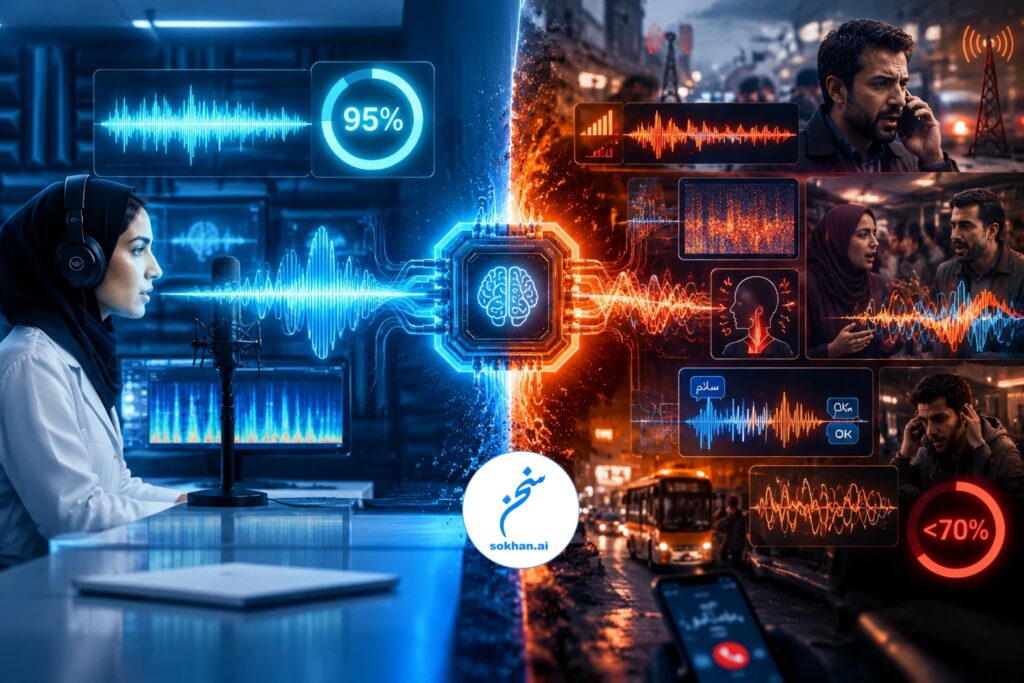
بسیاری از نرمافزارهای تجاری با ادعای دقت بالای ۹۵ درصد به بازار معرفی میشوند، اما این عدد در محیط آزمایشگاهی است. در واقعیت، سیستم پردازش گفتار فارسی وقتی در برابر خطوط تلفن پرنویز قرار میگیرد، دقتی کمتر از ۷۰ درصد از خود نشان میدهد. دلایل اصلی بروز این شکاف عمیق میان تئوری و عمل عبارتند از:
- افت ناگهانی نرخ سیگنال به نویز در تماسهای تلفن همراه
- نوسان شدید حجم صدای کاربران به دلیل استرس یا دوری از میکروفون
- استفاده همزمان از چند زبان، وامواژههای انگلیسی یا واژگان فنی
- همپوشانی صدای گویندگان در زمان مشاجره یا قطع کردن کلام یکدیگر
شناخت دقیق این تفاوتها مانع از شکست سرمایهگذاریهای سنگین سازمانها در پروژههای دیجیتال خواهد شد.
راهکارهای نوین برای آموزش و بومیسازی موتورهای گفتار
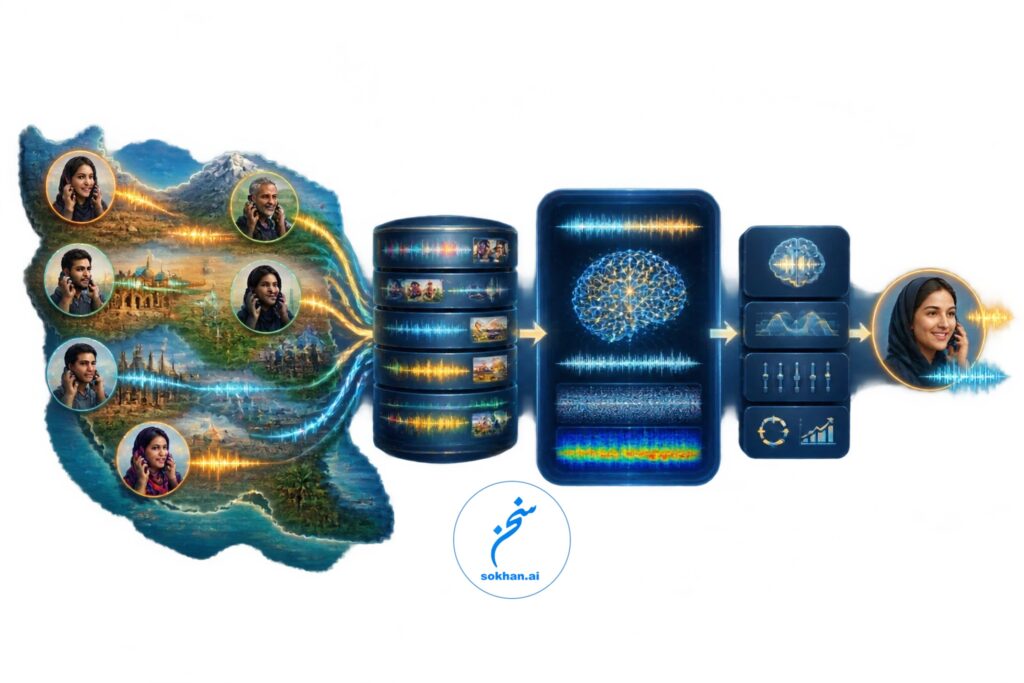
تنها راه عبور از این گردنهها، تمرکز بر دادگان صوتی متنوع و متناسب با شرایط واقعی است. یک سامانه موفق پردازش گفتار فارسی باید روی صدها هزار ساعت مکالمه ضبطشده از استانهای مختلف آموزش داده شود. استفاده از معماریهای یادگیری خودنظارتی به مدل اجازه میدهد حتی ویژگیهای پنهان نویزهای مخابراتی را یاد بگیرد. سازمانهای پیشرو با ترکیب مدلهای بومی، فیلترهای آکوستیک دقیق و الگوریتمهای یادگیری تقویتی توانستهاند خطای درک گفتار عامیانه را به حداقل ممکن کاهش دهند.
جمعبندی و گام بعدی
اجرای موفق سامانههای مبتنی بر صوت، نیازمند عبور از شعارهای بازاریابی و درک واقعیتهای فنی سخت این حوزه است. فناوری پردازش گفتار فارسی پایهایترین لایه در هوشمندسازی ارتباطات است و نقص در آن کل سیستم هوش مصنوعی را زمینگیر میکند. تنها سازمانهایی که با معماری اختصاصی و دادههای بومی این چالشها را حل کنند، به مزیت رقابتی پایدار دست خواهند یافت.
در مقاله دوم از این مجموعه، سراغ چالش فنی بعدی میرویم: «تفکیک گوینده (Speaker Diarization) در مکالمات تلفنی؛ چرا تفکیک صدای مشتری و کارشناس حیاتی است؟». در آنجا کالبدشکافی خواهیم کرد که سیستم چطور میفهمد چه کسی در چه ثانیهای صحبت کرده و چرا ادغام این صداها گزارشهای کیفی شما را نابود میکند!