وقتی صحبت از تحلیل خودکار مکالمات به میان میآید، اغلب افراد فقط به متن پیادهشده فکر میکنند. اما تصور کنید متنی طولانی بدون مشخص بودن گویندگان در اختیارتان قرار گیرد. در این حالت چگونه متوجه میشوید کدام جمله را مشتری عصبانی گفته و کدام پاسخ مودبانه از سمت کارشناس پشتیبانی بوده است؟ پیادهسازی دقیق فرایند تفکیک گوینده در مرکز تماس دقیقاً همان لایه گمشدهای است که به فایلهای متنی هویت و معنا میبخشد. بدون تفکیک صحیح کلام، سامانههای هوش مصنوعی دچار توهم تحلیلی میشوند و کارشناسان را به اشتباه مقصر جلوه میدهند. در این مقاله به بررسی چرایی اهمیت این فناوری و راهحلهای فنی آن در زیرساختهای واقعی میپردازیم.
اهمیت حیاتی تفکیک گوینده در مرکز تماس برای تحلیل دادهها
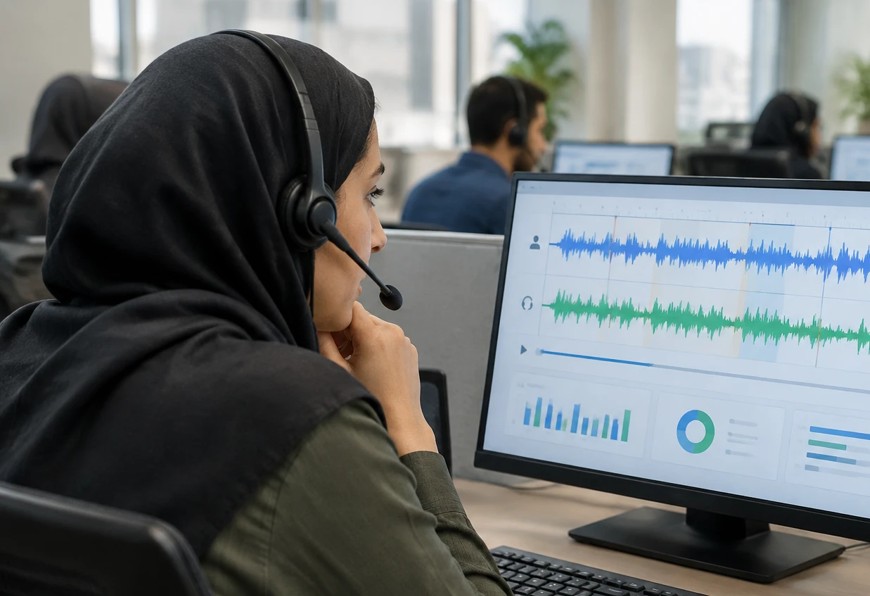
اگر ندانید چه کسی در چه لحظهای صحبت کرده، استخراج احساسات و تحلیل قصد کاربر عملاً ناممکن خواهد بود. اجرای بینقص الگوریتمهای تفکیک گوینده در مرکز تماس به سامانهها اجازه میدهد تایملاین دقیقی از مکالمه را ترسیم کنند. این الگوریتمها با تحلیل ویژگیهای آکوستیک صدا، مرز میان سخنان دو طرف را به طور خودکار تعیین میکنند. بنابراین، مدیران کنترل کیفیت میتوانند به جای گوش دادن به صدها ساعت فایل صوتی، مستقیماً بخشهای مرتبط با مشتری را فیلتر نمایند. این شفافیت دادهها، بهرهوری نظارتی را در کل سازمان چندین برابر بالا میبرد.
پیامدهای فاجعهبار ترکیب صدای مشتری و اپراتور
فرض کنید مشتری کلمات تند و غیرحرفهای به کار میبرد و سیستم این عبارات را به نام اپراتور ثبت کند. چنین خطاهایی بدون حضور سامانه تفکیک گوینده در مرکز تماس باعث کسر نمره ارزیابی پرسنل و نارضایتی شدید در تیم پشتیبانی میشود. از طرف دیگر، تحلیل نادرست احساسات، مدیران را در شناسایی علل ریشهای نارضایتی خریداران به اشتباه میاندازد. علاوه بر این، در گزارشهای پس از تماس (ACW)، ربات خلاصهنویس نمیتواند تعهدات واقعی کارشناس را از درخواستهای مشتری جدا سازد. در نتیجه، اعتماد به کل پلتفرم هوش مصنوعی از بین خواهد رفت.
چالشهای فنی پیادهسازی تفکیک گوینده در مرکز تماس
جداسازی صداها روی کاغذ ساده است، اما در بستر خطوط تلفنی با پارامترهای نامشخص به یک چالش محاسباتی بدل میشود. دقت عملکرد سیستمهای تفکیک گوینده در مرکز تماس به شدت تحت تاثیر عواملی چون نویز خط و کیفیت فشردهسازی قرار دارد. مدلهای یادگیری عمیق باید در کمتر از چند ثانیه، بردار صوتی هر شخص (Voice Embeddings) را بدون آموزش قبلی شناسایی کنند. این کار زمانی دشوارتر میشود که دو نفر همزمان صحبت کنند یا صدای نفس کشیدن و اصوات تصادفی ثبت شود. به همین دلیل، انتخاب مدل مناسب نیازمند درک عمیق از زیرساختهای مخابراتی است.
معماری کانال تکخطی در برابر تماسهای استریو
اگر تماسها به صورت دو کاناله (Stereo) ضبط شوند، صدای مشتری روی یک کانال و صدای اپراتور روی کانال دیگر ذخیره میگردد. در این شرایط، نیاز به پردازش پیچیده برای تفکیک گوینده کاهش مییابد. با این حال، اکثر مراکز تماس سنتی به دلیل کمبود فضا، صوت را به صورت تککاناله (Mono) ذخیره میکنند. اینجاست که الگوریتمهای پیشرفته یادگیری ماشین برای خوشهبندی ویژگیهای گفتاری وارد میدان میشوند تا صدای درهمتنیده را از هم جدا سازند.

نقش تفکیک گوینده در مرکز تماس بر بهبود خودکار شاخصهای کیفی
با تفکیک دقیق صداها، موتورهای تحلیل میتوانند متریکهای طلایی و نادیدهگرفتهشده عملیات را در لحظه اندازهگیری کنند. با پیادهسازی تفکیک گوینده در مرکز تماس، دسترسی به اطلاعات ارزشمند زیر فراهم خواهد شد:
- نسبت صحبت به سکوت (Talk-to-Listen Ratio): آیا اپراتور بیشتر گوش میدهد یا مدام صحبت مشتری را قطع میکند؟
- شناسایی لحظات همپوشانی (Cross-Talk): اندازهگیری دفعاتی که تنش کلامی میان دو طرف بالا میگیرد.
- محاسبه دقیق مکثها (Dead Air): تشخیص زمانهایی که کارشناس مشتری را بدون دلیل پشت خط منتظر نگه میدارد.
- استخراج احساسات تفکیکشده: مقایسه نمودار احساسی مشتری در ثانیه نخست تماس با ثانیه پایانی مکالمه.
این شاخصها به مربیان آموزشی اجازه میدهد جلسات کوچینگ هدفمند و مبتنی بر شواهد غیرقابلانکار برگزار کنند.
آینده تحلیل صوت و راهکارهای غلبه بر همپوشانی کلام
بزرگترین مرز فناوری صوتی امروزی، مدیریت زمانهایی است که مشتری و کارشناس همزمان روی صدای یکدیگر صحبت میکنند. برای حل این مشکل، نسل جدید الگوریتمهای جداسازی منبع صوتی (Blind Source Separation) توسعه یافتهاند. این مدلها به کمک توجه مکانی و یادگیری عمیق میتوانند سیگنالهای صوتی درهمآمیخته را باز کنند و تحویل موتور هوش مصنوعی دهند. سازمانهایی که چنین زیرساختهایی را مستقر کنند، اولین شرکتهایی خواهند بود که از خطاهای گزارشگیری خلاص میشوند.
جمعبندی و گام بعدی
دستیابی به هوش مصنوعی کارآمد در مرکز تماس، بدون تفکیک دقیق طرفین گفتگو یک توهم غیرممکن است. سرمایهگذاری روی تفکیک گوینده در مرکز تماس شالوده محکمی برای تحلیل احساسات، ارزیابی خودکار کیفیت و خلاصهسازی بیخطا میسازد. نادیده گرفتن این حلقه مفقوده، هزینههای فناوری شما را هدر میدهد و دادههای غلط به همراه میآورد.
در مقاله سوم از این مجموعه شگفتانگیز، وارد مرز باریک سرعت و انساننمایی میشویم: «هوش مصنوعی صوتی فولدوپلکس (Full-Duplex)؛ راز مکالمه طبیعی بدون تاخیر و قطع کلام». در آنجا بررسی میکنیم چرا مکثهای ۲ ثانیهای، چتباتهای صوتی را غیرقابلتحمل میکنند و نسل جدید چگونه مثل انسان حرف مخاطب را میشنود و قطع میکند!